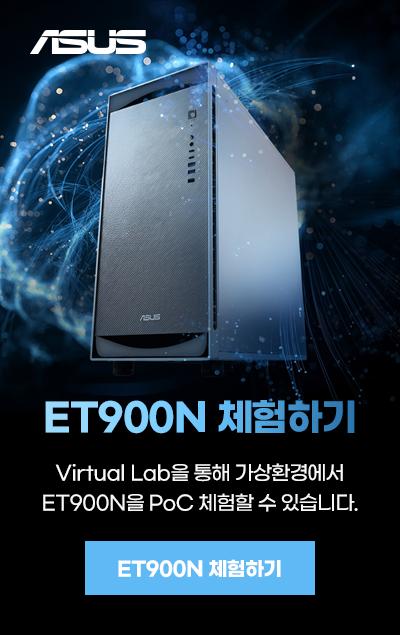
ET900N G3
Grace Blackwell Ultra
데스크사이드 AI
NVIDIA GB300 Grace Blackwell Ultra Desktop Superchip 탑재
748GB 통합 코히런트 메모리와 20 PFLOPS FP4 성능을 데스크 위에서 구현합니다.
CES 2026에서 공개된 DGX Station 아키텍처 기반 최초의 데스크사이드 AI 슈퍼컴퓨터 중 하나입니다.
20PFLOPS
FP4 AI 연산 성능
748GB
통합 코히런트 메모리 (CPU+GPU)
1T+
파라미터 모델 로컬 실행
2×
4GPU 워크스테이션 대비 GPU 메모리
ET900N G3가 특별한 이유
DGX Station 아키텍처를 데스크사이드 폼팩터로 구현해 대형 모델 개발, 멀티모달 AI 연구, 온프레미스 보안이 필요한 AI 워크로드에 최적화되어 있습니다.
748GB 통합 코히런트 메모리
CPU LPDDR5X 496 GB + GPU HBM3e 252 GB를 단일 메모리 공간으로 운용
4GPU 워크스테이션의 2배 이상 GPU 메모리를 단일 시스템으로 구현
4GPU 워크스테이션의 2배 이상 GPU 메모리를 단일 시스템으로 구현
20 PFLOPS FP4 AI 성능
5세대 Tensor Core + FP4 정밀도로 LLM 파인튜닝, 딥러닝 학습, 복합 시뮬레이션을 페타플롭스 수준에서 처리
2노드 연결 확장
ET900N G3 2대를 상호 연결해 통합 메모리와 성능을 2배로 확장
서버 클러스터 구성 없이 대형 모델 실험 가능
서버 클러스터 구성 없이 대형 모델 실험 가능
NVIDIA AI 소프트웨어 스택
DGX OS 기반 턴키 개발 환경
CUDA-X 라이브러리, AI Enterprise 소프트웨어 사전 탑재로 설치 없이 바로 개발 시작 가능
CUDA-X 라이브러리, AI Enterprise 소프트웨어 사전 탑재로 설치 없이 바로 개발 시작 가능
온프레미스 데이터 보안
클라우드 전송 없이 내부망에서 민감 데이터 처리
금융·의료·연구기관의 데이터 컴플라이언스 요건 충족
금융·의료·연구기관의 데이터 컴플라이언스 요건 충족
DGX 아키텍처 코드 호환
데이터센터 GB300 NVL72와 동일한 소프트웨어 스택
로컬에서 작성한 코드를 서버 클러스터에 수정 없이 배포
로컬에서 작성한 코드를 서버 클러스터에 수정 없이 배포
ASUS ExpertCenter Pro ET900N G3 상세 스펙
프로세서 & GPU
| 사양 | 내용 |
|---|---|
| 슈퍼칩 | NVIDIA GB300 Grace Blackwell Ultra Desktop Superchip |
| CPU | NVIDIA Grace — 72코어 ARM Neoverse V2 |
| GPU | NVIDIA Blackwell Ultra (B300) — 온보드 |
| CPU-GPU 인터커넥트 | NVIDIA NVLink-C2C (고대역폭 칩-투-칩) |
| AI 연산 성능 | 최대 20 PFLOPS (FP4 NVFP4) |
메모리
| 사양 | 내용 |
|---|---|
| GPU 메모리 | 252 GB HBM3e (온보드, 7.1 TB/s 대역폭) |
| 시스템 메모리 | 496 GB LPDDR5X (396 GB/s 대역폭) |
| 통합 코히런트 메모리 | 최대 748 GB (CPU + GPU 단일 주소 공간) |
네트워크 & 입출력
| 사양 | 내용 |
|---|---|
| AI 네트워크 | NVIDIA ConnectX-8 SuperNIC — 최대 800 Gb/s (듀얼 QSFP 포트) |
| 관리 네트워크 | 1 GbE (BMC 전용) |
| 추가 네트워크 | 10 GbE LAN |
소프트웨어 & 운영체제
| 사양 | 내용 |
|---|---|
| 운영체제 | NVIDIA DGX OS (Linux 기반) |
| AI 소프트웨어 스택 | NVIDIA AI Enterprise, CUDA-X 라이브러리 사전 탑재 |
| 지원 프레임워크 | PyTorch, TensorFlow, JAX, NVIDIA NeMo, TensorRT |
| 지원 모델 | DeepSeek V3.2, Llama 4, Mistral Large 3, Gemma 3 등 |
냉각 & 전원
| 사양 | 내용 |
|---|---|
| 냉각 방식 | 폐쇄형 액체 냉각 (Closed-loop Liquid Cooling) |
| TDP | 1,600 W |
| 폼팩터 | 데스크사이드 타워 |
ET900N G3로 할 수 있는 것
대형 언어 모델, 멀티모달 AI, 데이터 사이언스, 자율 에이전트 개발 등 고성능 로컬 AI 인프라가 필요한 조직에 적합합니다.
LLM 로컬 파인튜닝 & 추론
748 GB 통합 메모리로 1조 파라미터 모델을 클라우드 없이 로컬에서 실행
클라우드 비용 없이 Llama 4, DeepSeek V3 등 대형 모델 파인튜닝 가능
클라우드 비용 없이 Llama 4, DeepSeek V3 등 대형 모델 파인튜닝 가능
멀티모달 AI 연구 & 개발
이미지·텍스트·음성 복합 모델 학습
거대한 통합 메모리 덕분에 멀티모달 배치 처리 병목 없이 연속 실험 가능
거대한 통합 메모리 덕분에 멀티모달 배치 처리 병목 없이 연속 실험 가능
데이터 사이언스 & 시뮬레이션
금융 리스크 시뮬레이션, 분자 동역학, 기후 모델 등 대규모 과학 계산을 데스크사이드에서 처리
연구기관·대학에 최적
연구기관·대학에 최적
자율 에이전트 AI 개발
NVIDIA NemoClaw 지원으로 로컬에서 자율 AI 에이전트 구축·테스트
민감 데이터가 외부로 유출되지 않는 온프레미스 에이전트 개발 환경.
민감 데이터가 외부로 유출되지 않는 온프레미스 에이전트 개발 환경.
ASUS ET900N G3 도입을 검토 중이신가요?
출시 예정 제품 사전 견적, 구축 환경 검토, AI 인프라 컨설팅을 한국인프라에서 안내해드립니다.