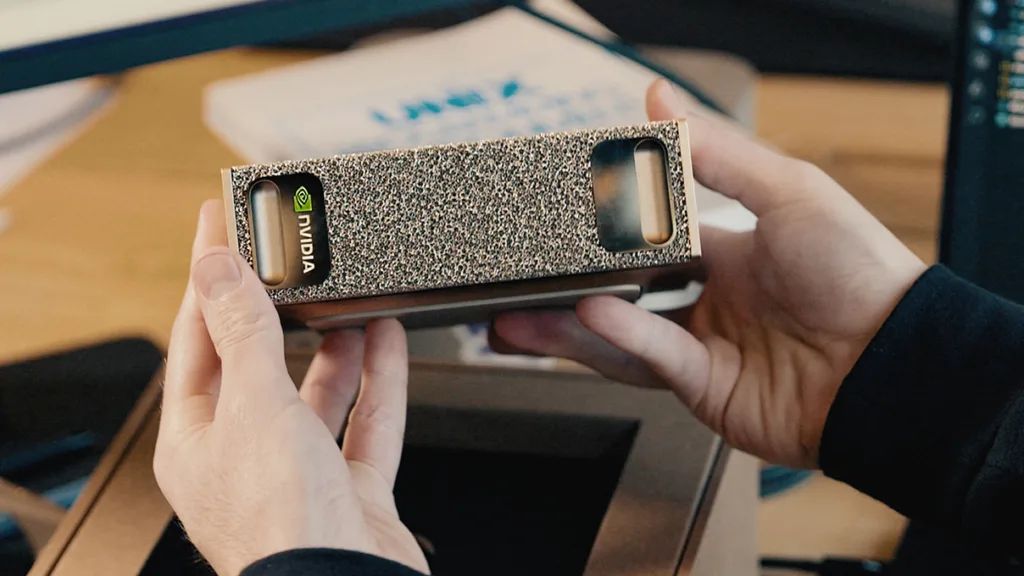
DGX Spark
GB10 Grace Blackwell 기반 개인용 AI 슈퍼컴퓨터.
AI·딥러닝·HPC 워크로드에 최적화된 NVIDIA DGX, HGX, RTX PRO, Jetson 등 전 제품군을 공식 파트너로서 공급·구축·지원합니다.
문의하기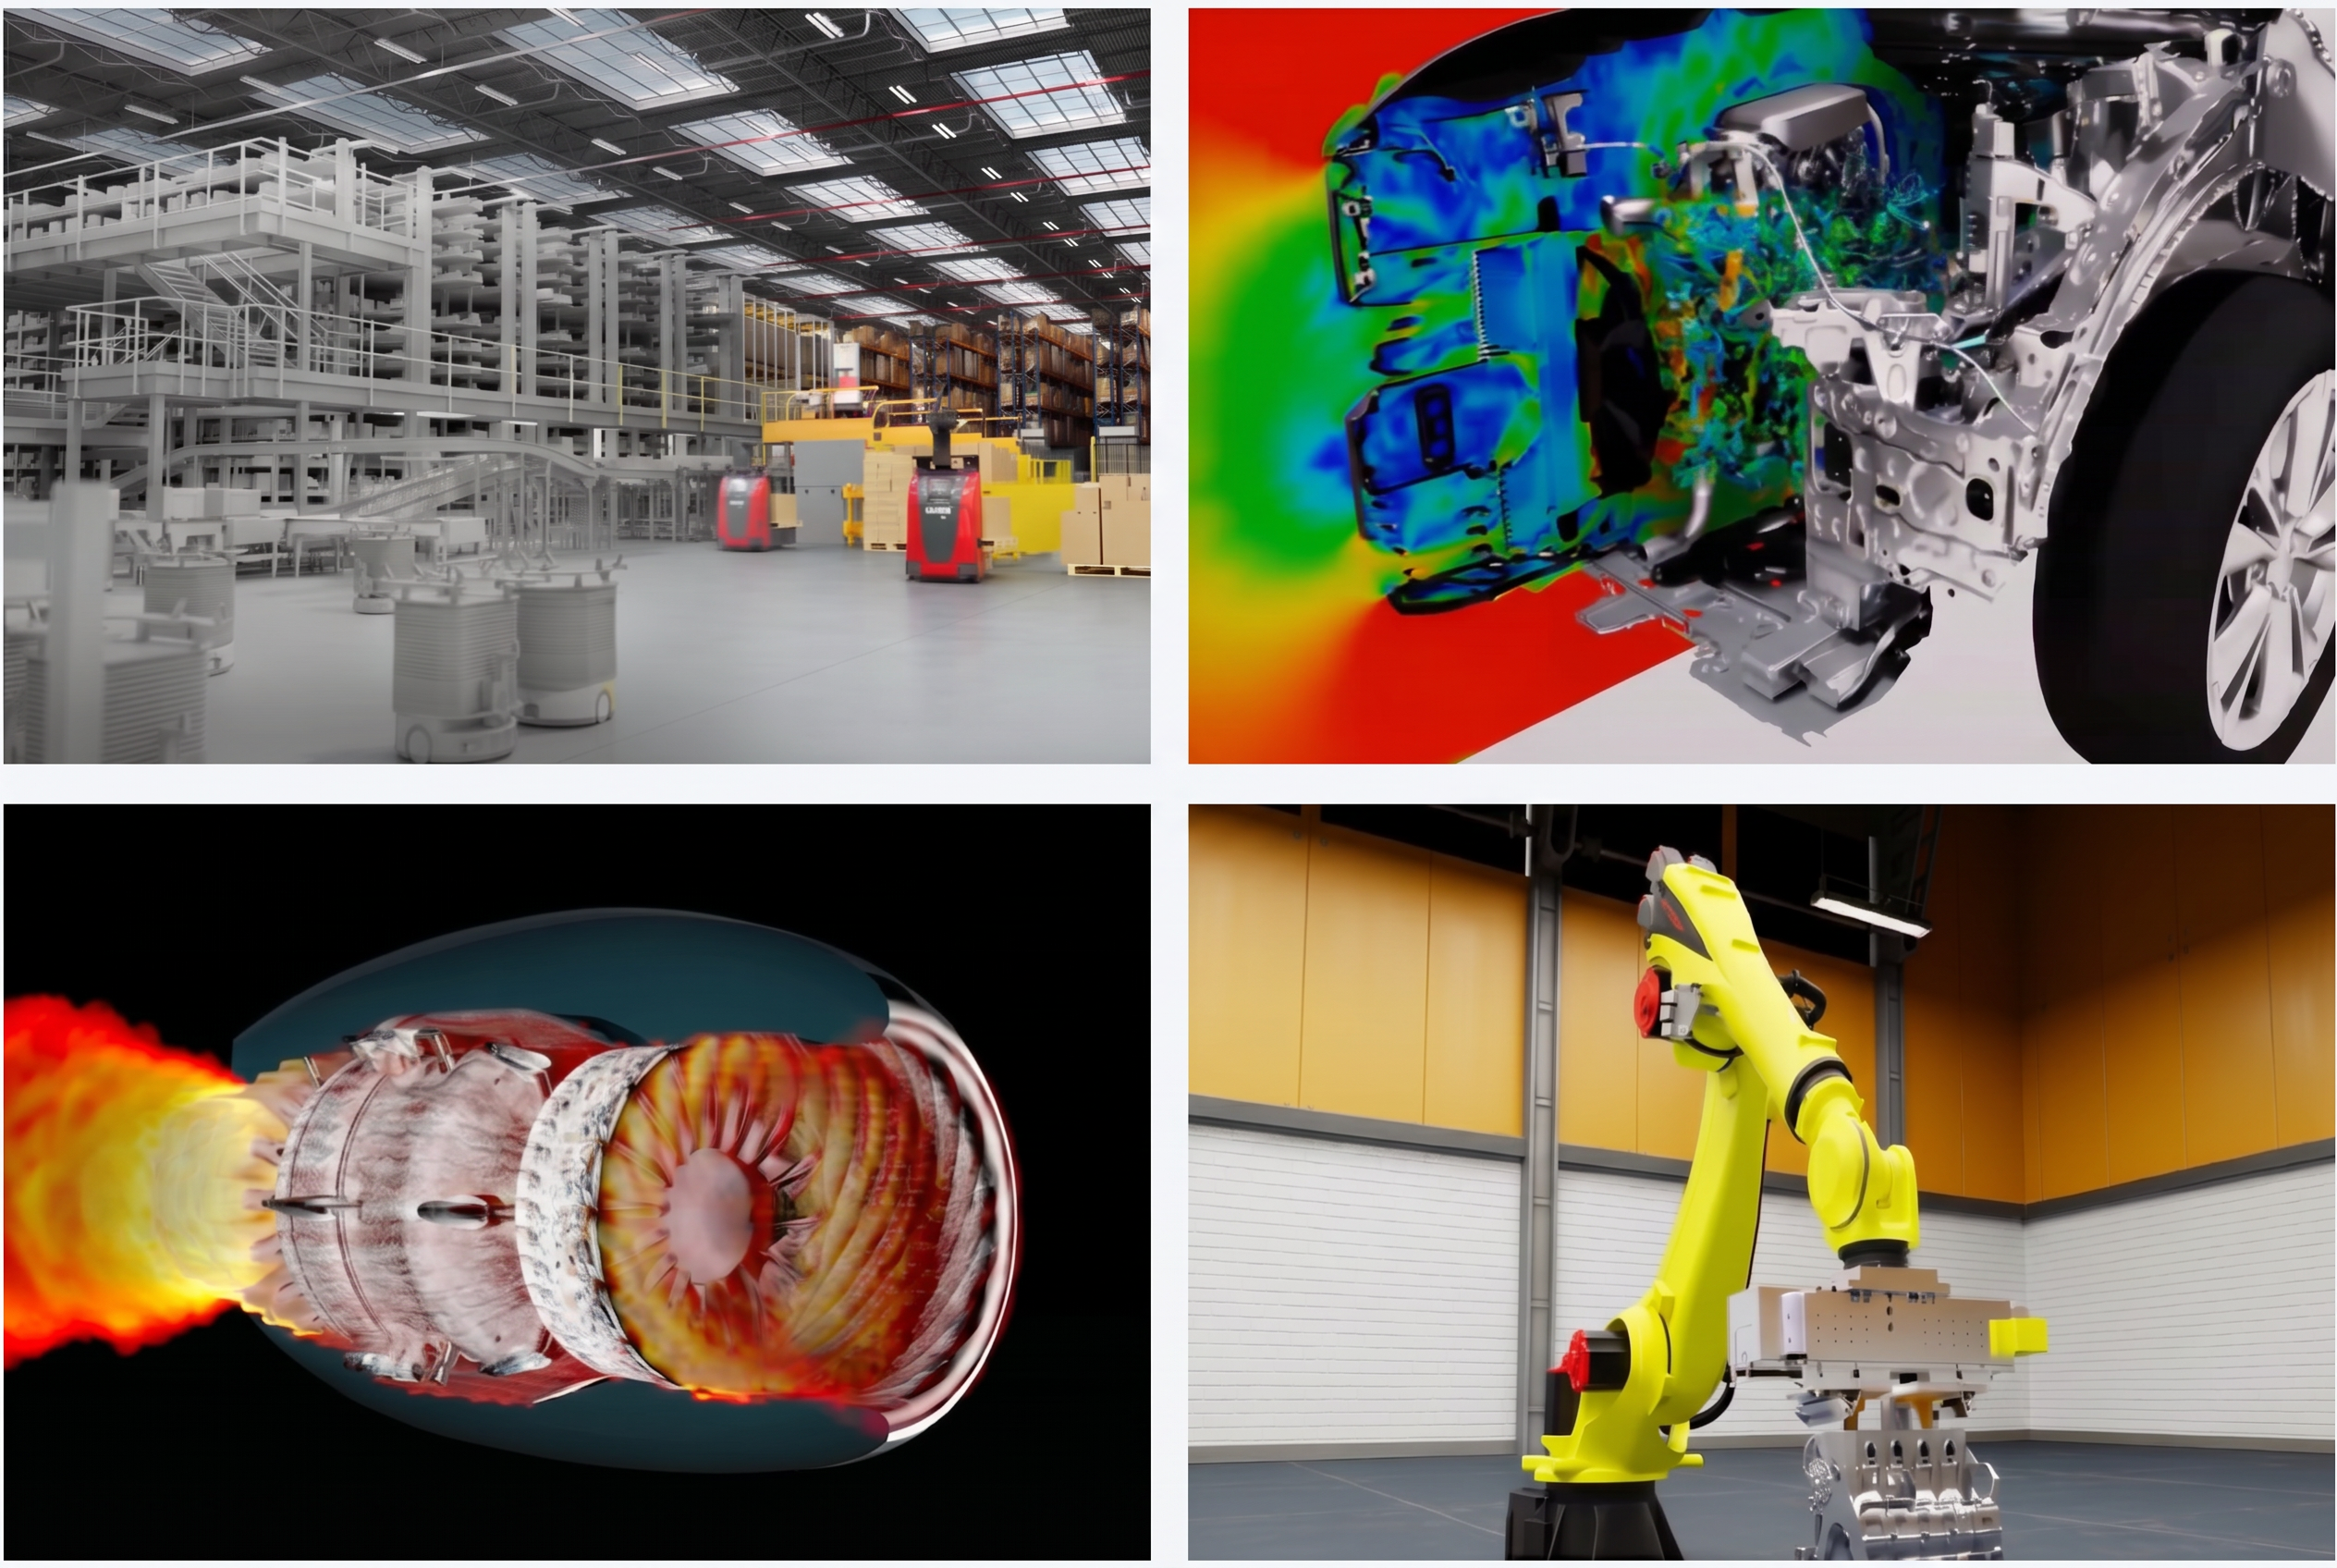
Product Overview
(주)한국인프라는 NVIDIA 공식 파트너로서 생성형 AI, Physical AI, 대규모 LLM 학습·추론에 최적화된 NVIDIA 풀스택 솔루션을 공급합니다.
DGX 시스템, HGX 기반 서버, RTX PRO 워크스테이션, Jetson 엣지 디바이스까지 고객 워크로드에 최적화된 구성 컨설팅부터 설치·운영까지 원스톱으로 지원합니다.
LINEUP
AI 데이터센터부터 엣지 디바이스까지, 워크로드에 맞는 NVIDIA 전 제품군을 확인하세요.
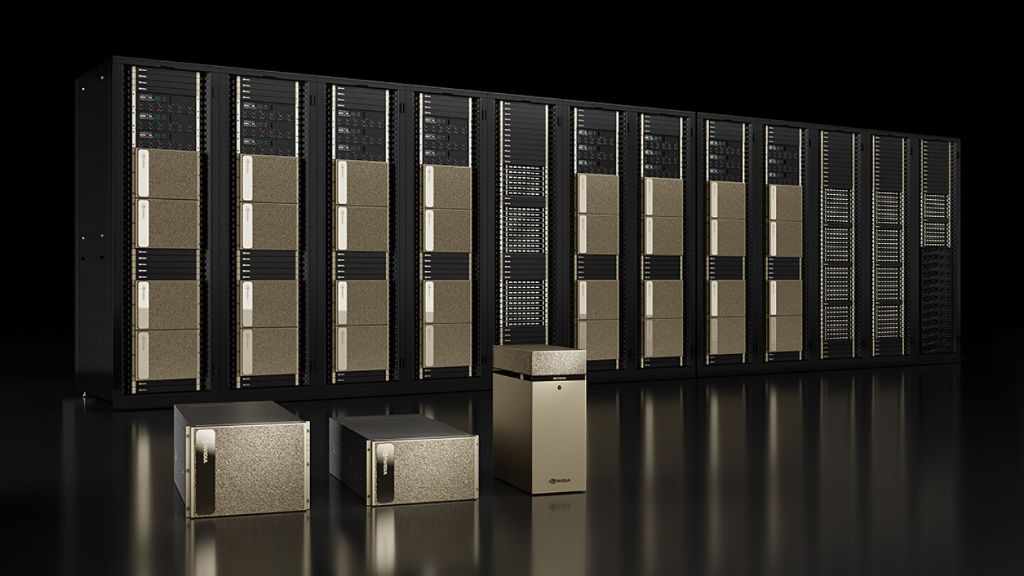
Blackwell Ultra GPU 기반 AI 팩토리 전용 턴키 시스템
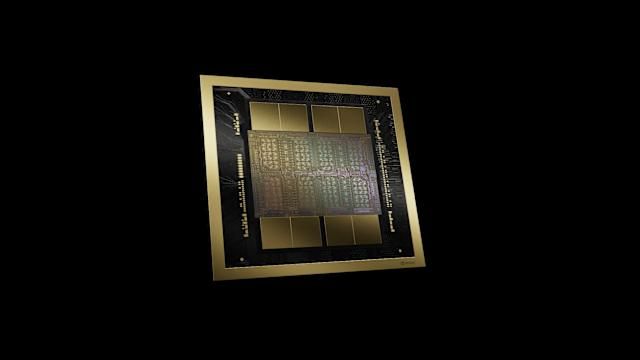
데이터센터·HPC를 위한 NVIDIA Tensor Core GPU
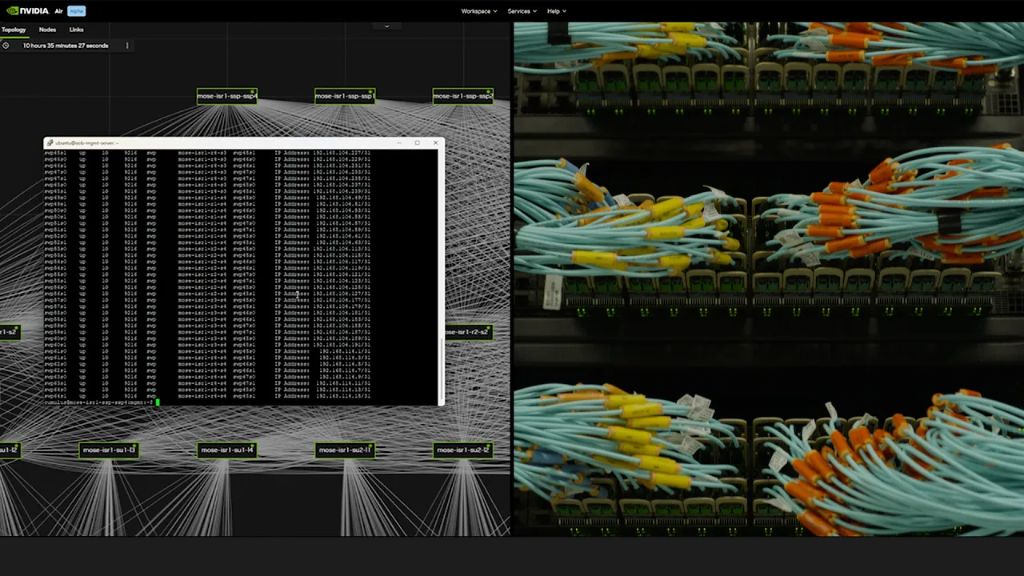
GPU 간 초고속 통신을 위한 InfiniBand · Spectrum-X
AI 개발·3D 렌더링을 위한 RTX PRO 워크스테이션
엔터프라이즈 AI 개발·배포 소프트웨어 스택
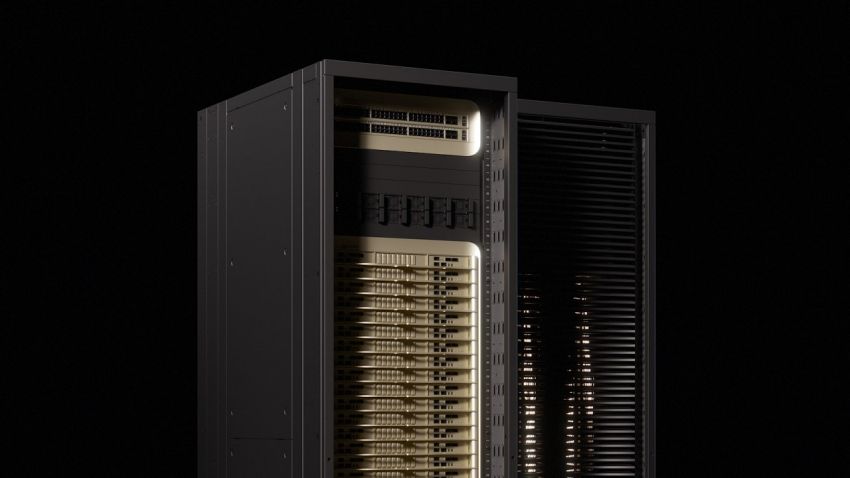
Omniverse·디지털 트윈을 위한 RTX 가속 서버
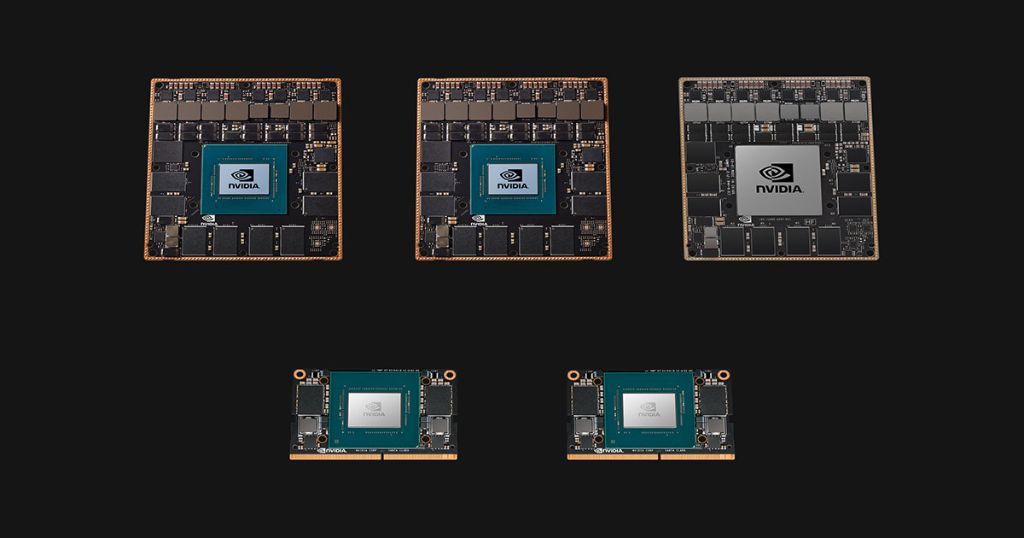
로보틱스·자율 시스템을 위한 Jetson 엣지 AI 모듈
DGX SYSTEMS
AI 팩토리를 위한 NVIDIA의 턴키 슈퍼컴퓨터 — 학습부터 추론까지 즉시 가동 가능한 풀스택 솔루션입니다.
GB10 Grace Blackwell 기반 개인용 AI 슈퍼컴퓨터.
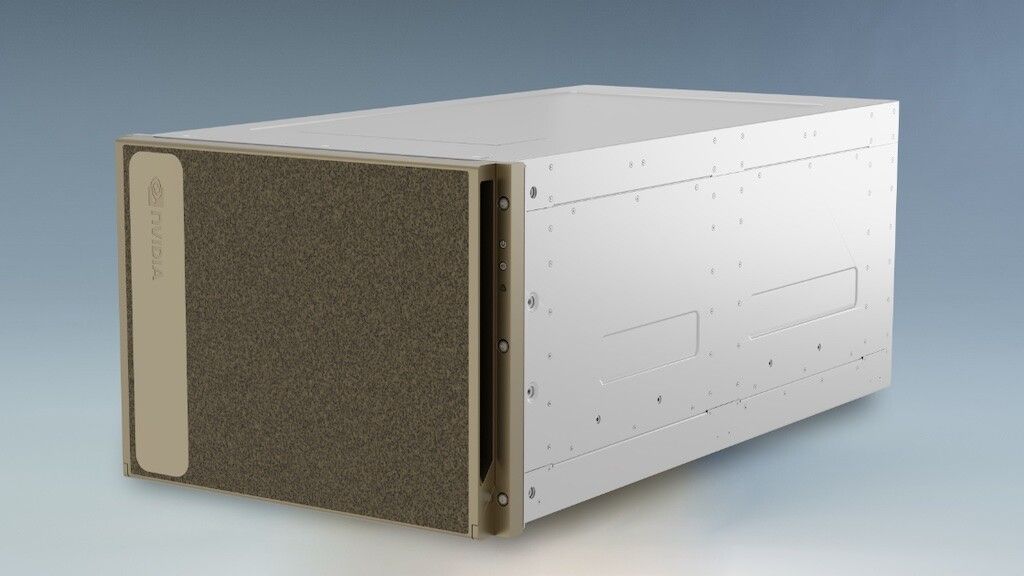
Hopper 8-GPU·1,128GB HBM3e 탑재 LLM 시스템.
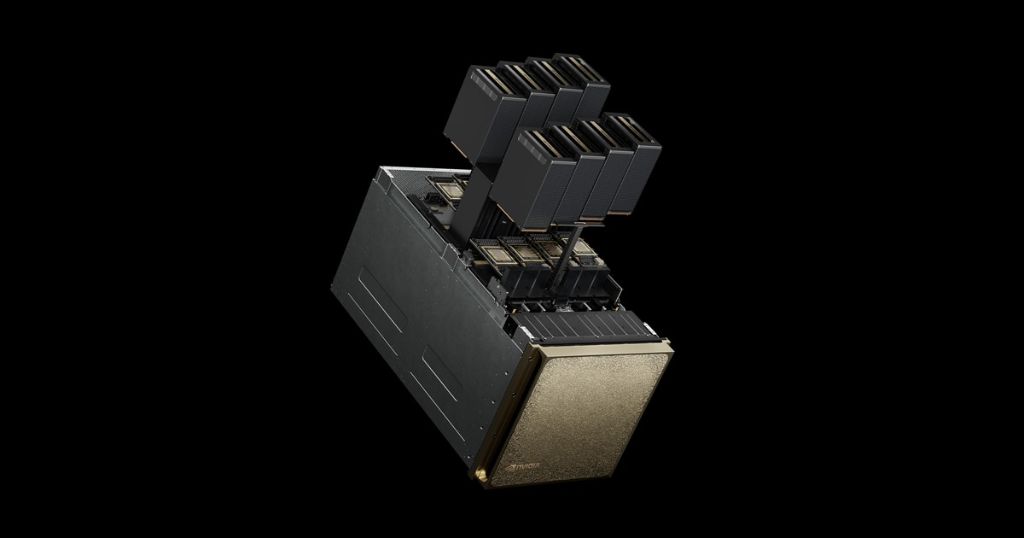
Blackwell 8-GPU, FP4 추론 15× 가속 학습 플랫폼.
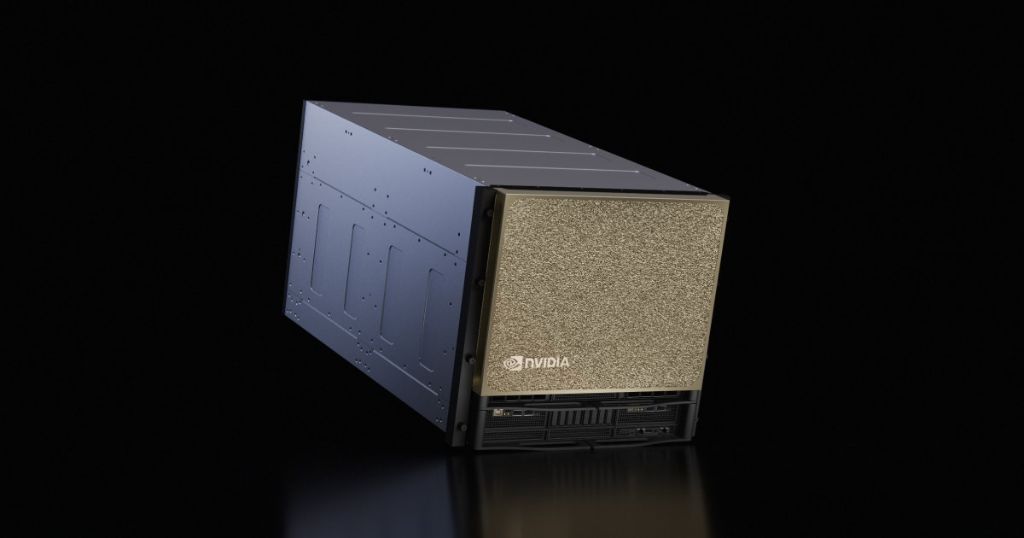
Blackwell Ultra 기반 추론 11× 최상위 시스템.
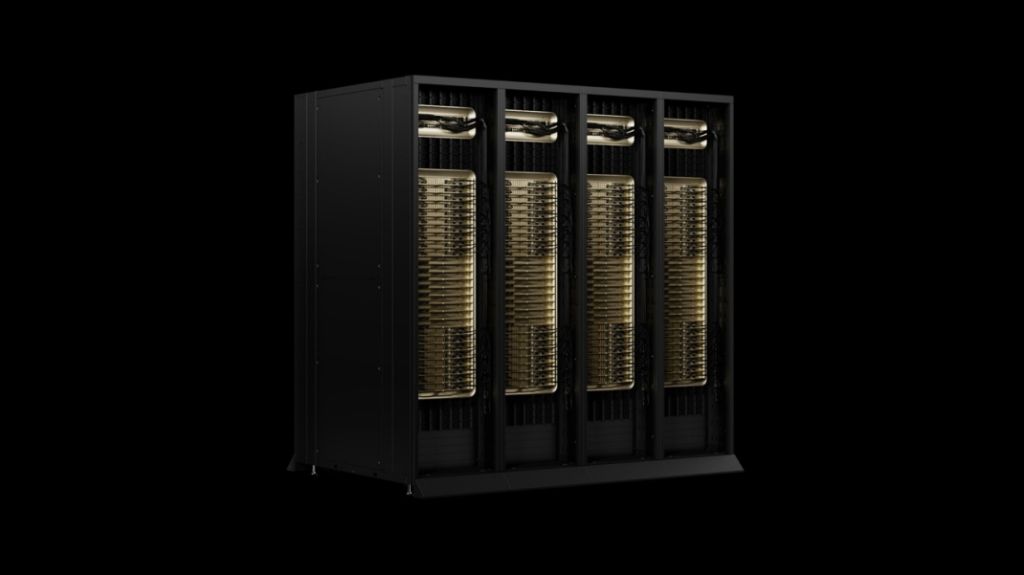
검증된 다중 노드 AI 인프라 표준 클러스터.
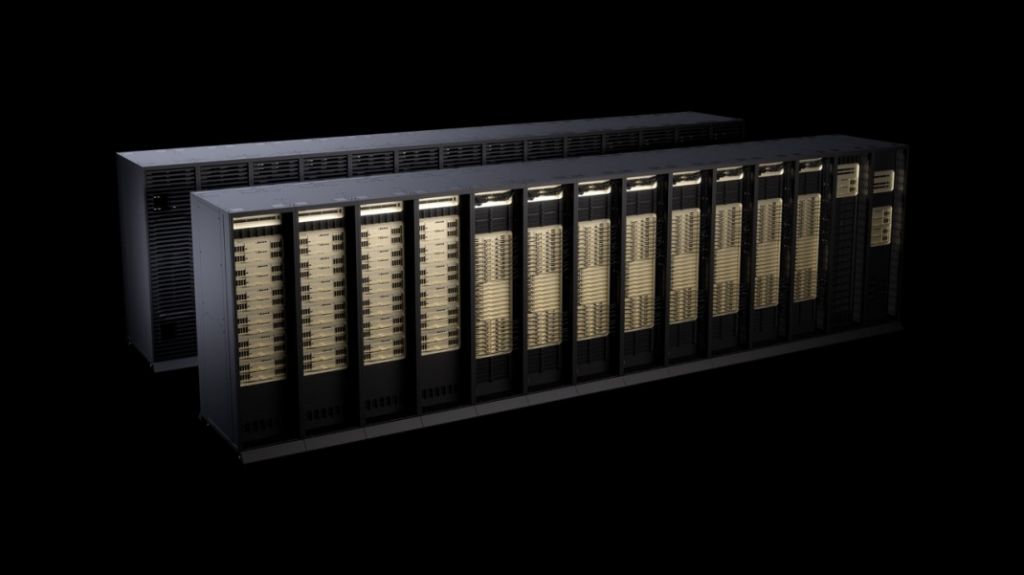
수십~수백 노드 풀 스케일 AI 슈퍼컴퓨터.
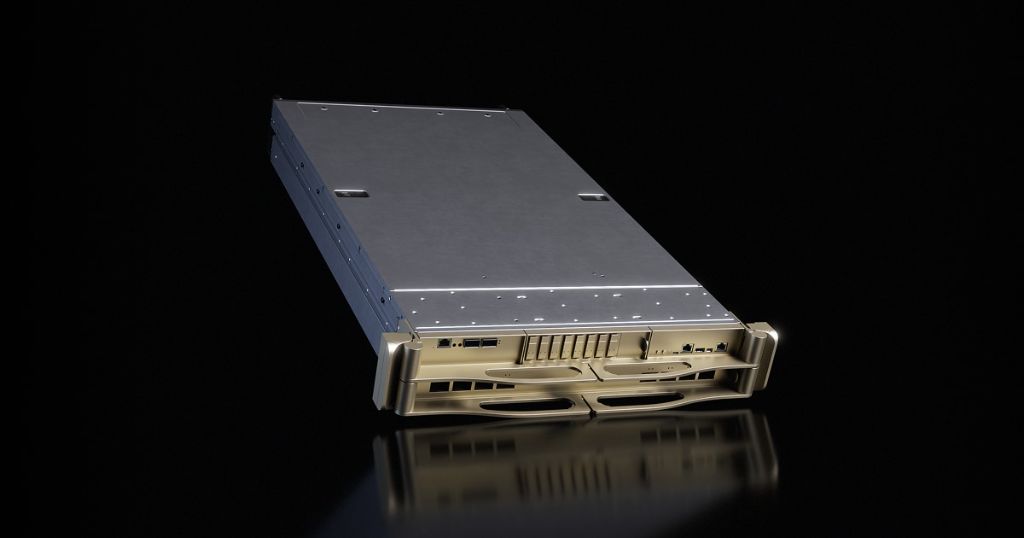
차세대 Rubin 8-GPU NVLink 최상위 시스템.
GPU·CPU·네트워킹·스토리지·NVIDIA AI Enterprise S/W까지 단일 패키지로 즉시 도입.
NVIDIA가 직접 검증한 BasePOD/SuperPOD 레퍼런스로 도입 리스크와 구축 기간을 최소화.
NVIDIA Mission Control과 24/7 글로벌 기술지원으로 운영 안정성을 확보합니다.
단일 노드부터 수백 노드 SuperPOD까지 동일 아키텍처로 단계적 확장이 가능합니다.
DATA CENTER GPU
데이터센터·HPC·생성형 AI를 위한 NVIDIA Tensor Core GPU 라인업입니다.
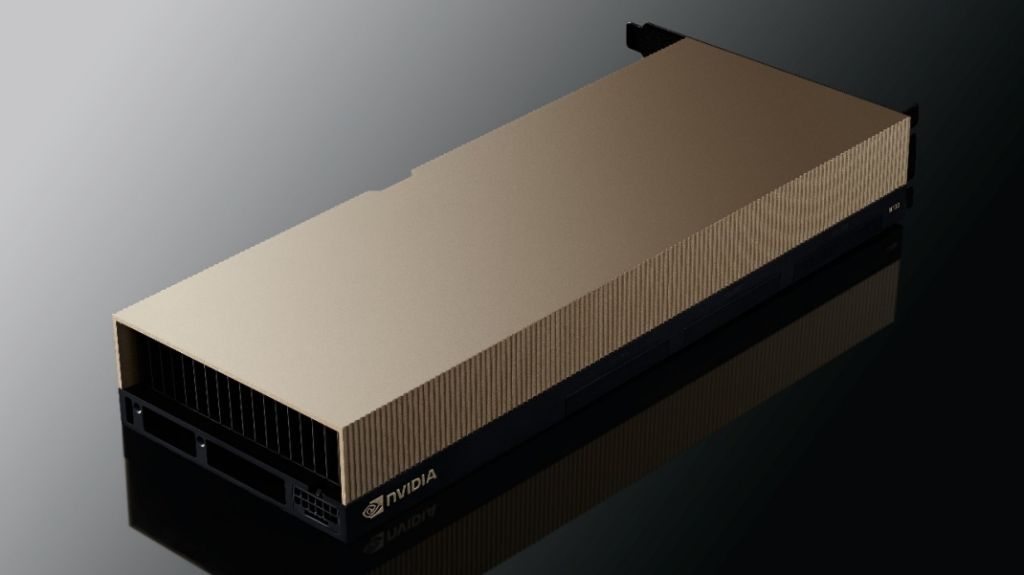
Hopper 아키텍처 141GB HBM3e 메모리·4.8TB/s 대역폭의 듀얼슬롯 PCIe NVL 폼팩터 데이터센터 GPU.
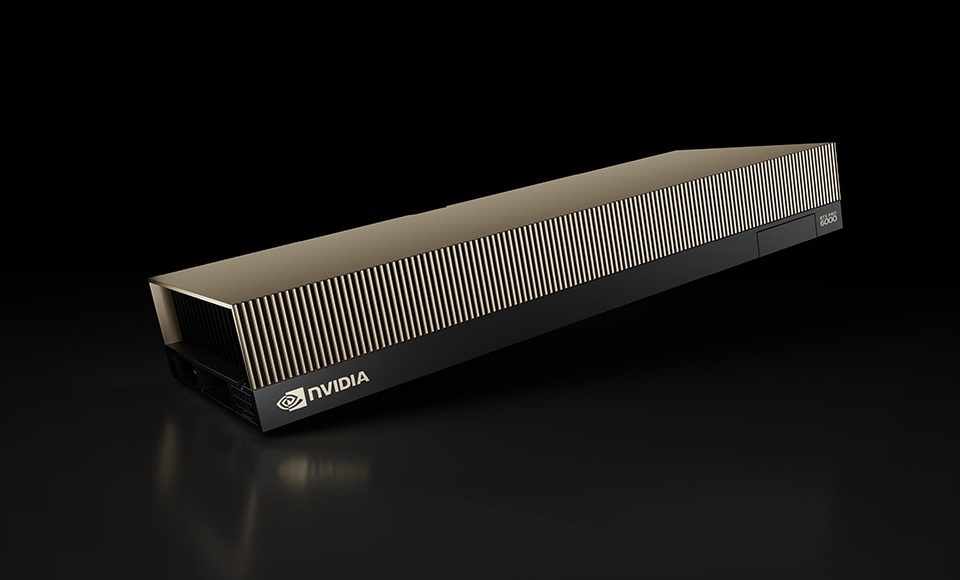
Blackwell 기반 96GB GDDR7 듀얼슬롯 패시브 쿨링 서버 전용 데이터센터 GPU.
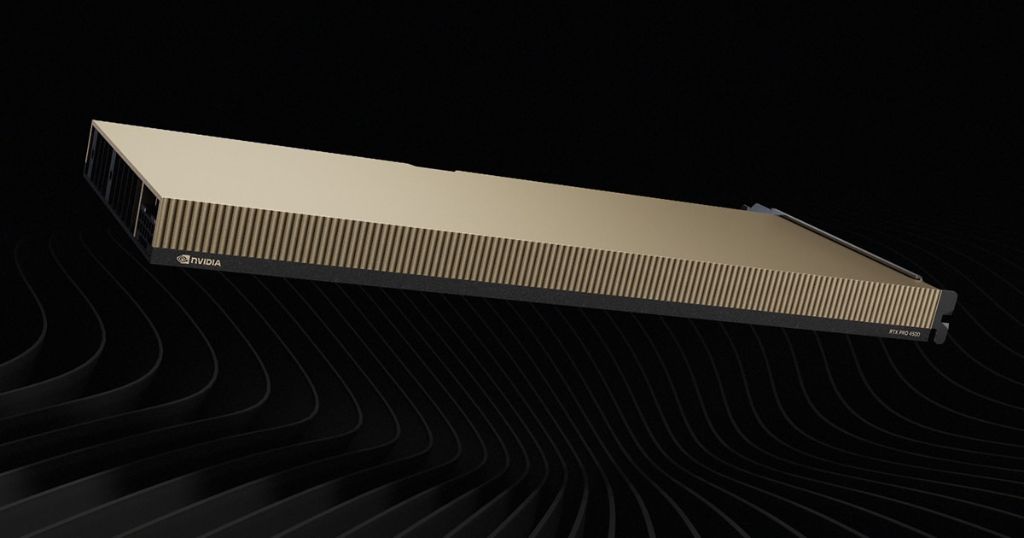
Blackwell 기반 32GB GDDR7 듀얼슬롯 패시브 쿨링 미드레인지 서버 GPU.
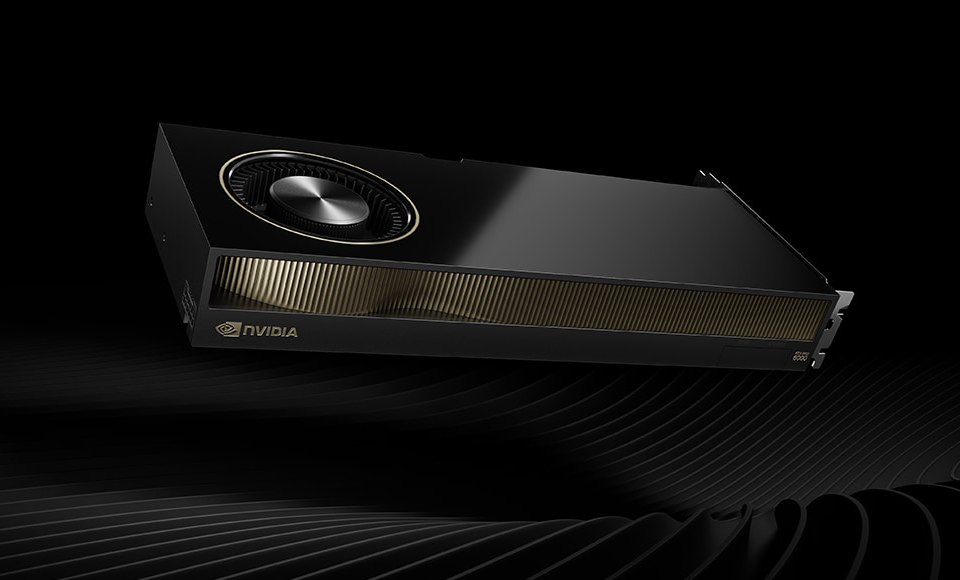
Blackwell 96GB GDDR7 데이터센터 GPU.
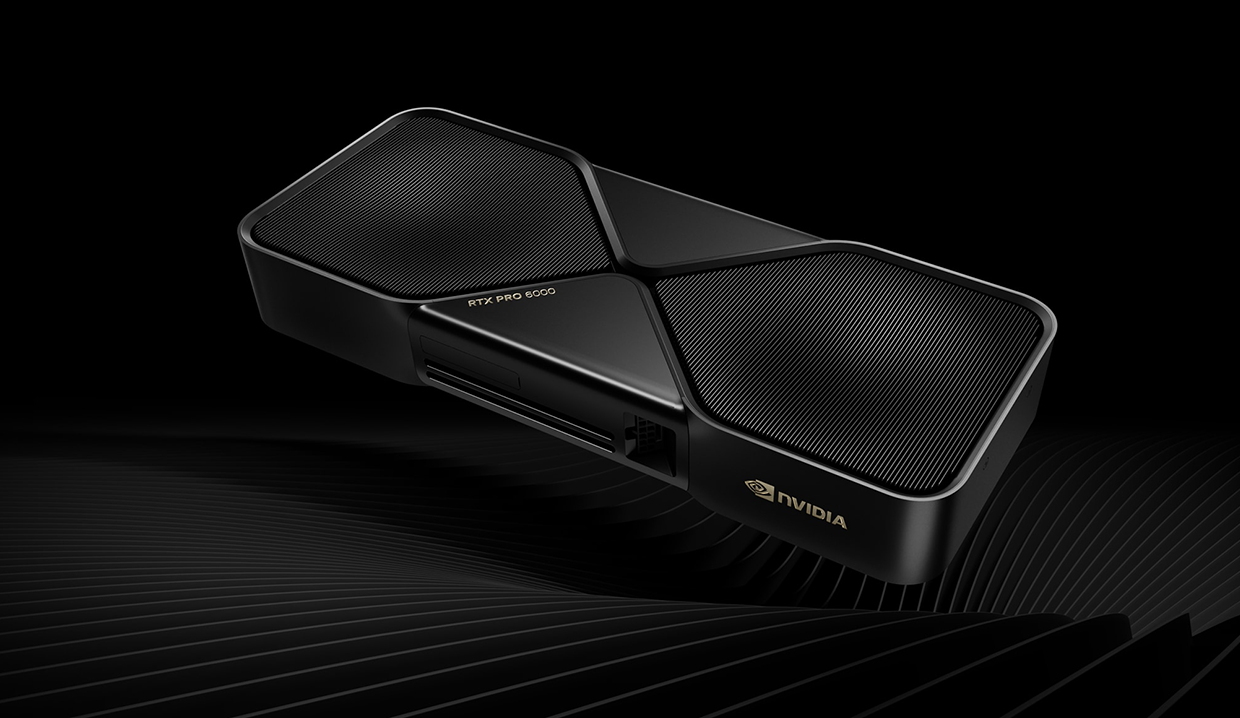
Blackwell 96GB GDDR7 데이터센터 GPU.
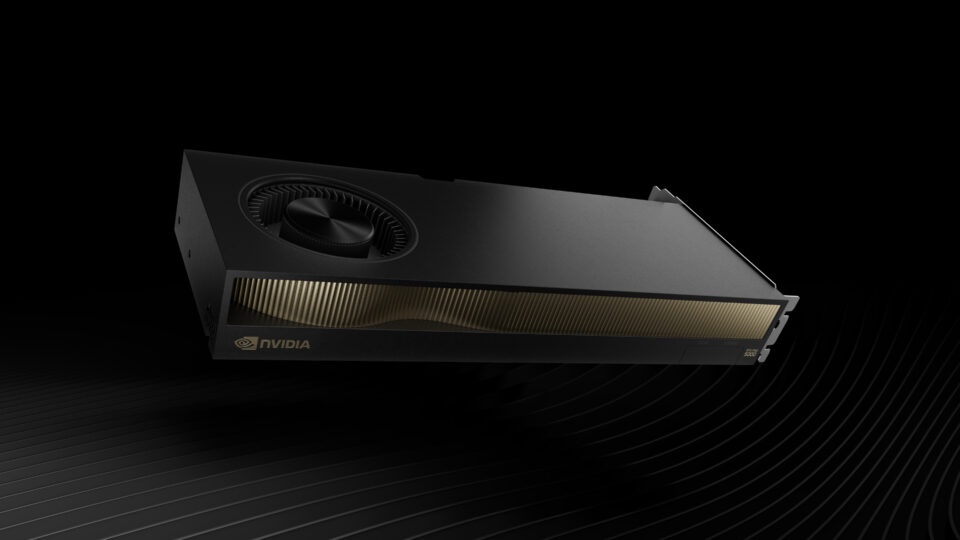
Blackwell 72GB GDDR7 ECC 대용량 메모리·블로어 쿨링 프로페셔널 GPU.
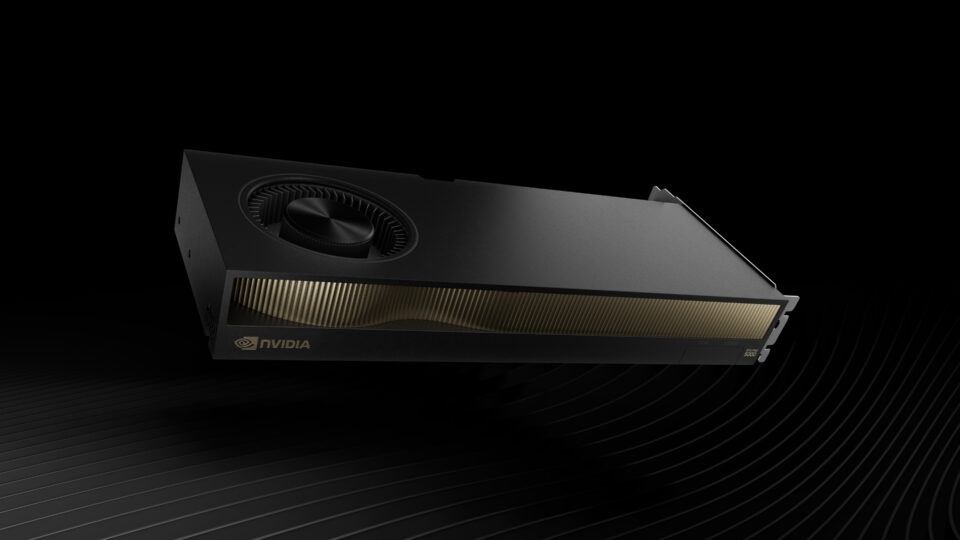
Blackwell 48GB GDDR7 ECC 듀얼슬롯 블로어 쿨링 프로페셔널 GPU.
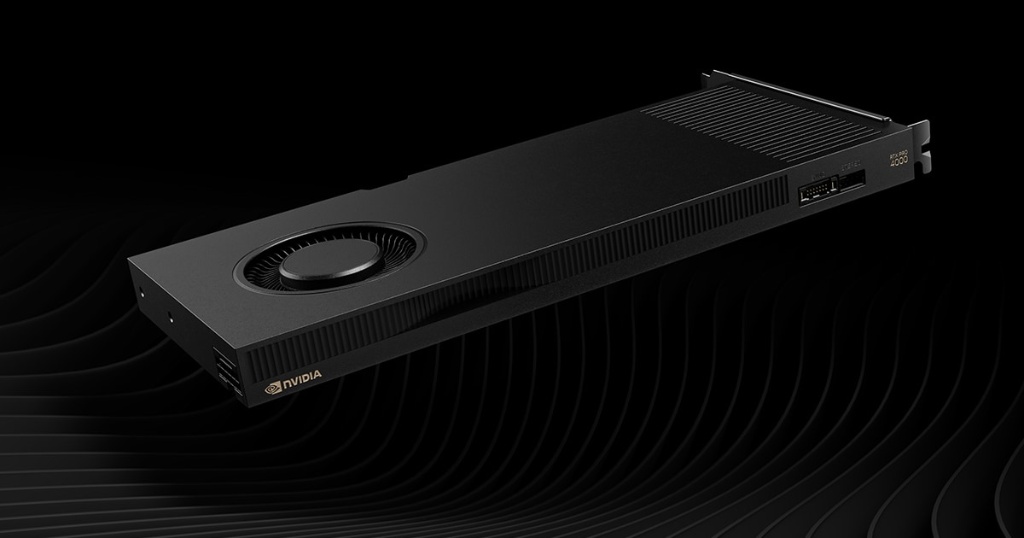
Blackwell 24GB GDDR7 ECC 싱글슬롯 블로어 쿨링 컴팩트 프로페셔널 GPU.
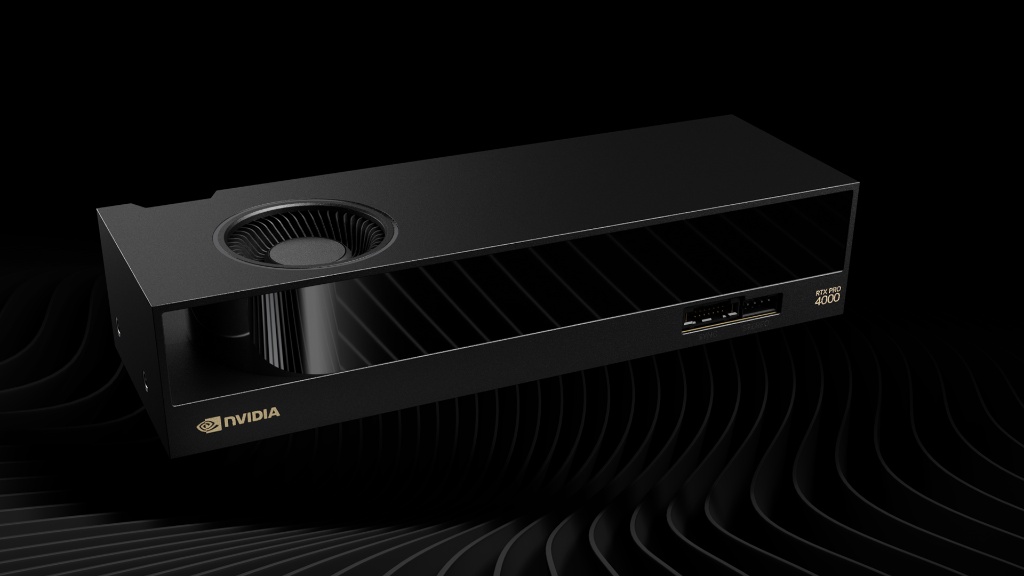
Blackwell 16GB GDDR7 ECC 싱글슬롯 블로어 쿨링 엔트리 프로페셔널 GPU.
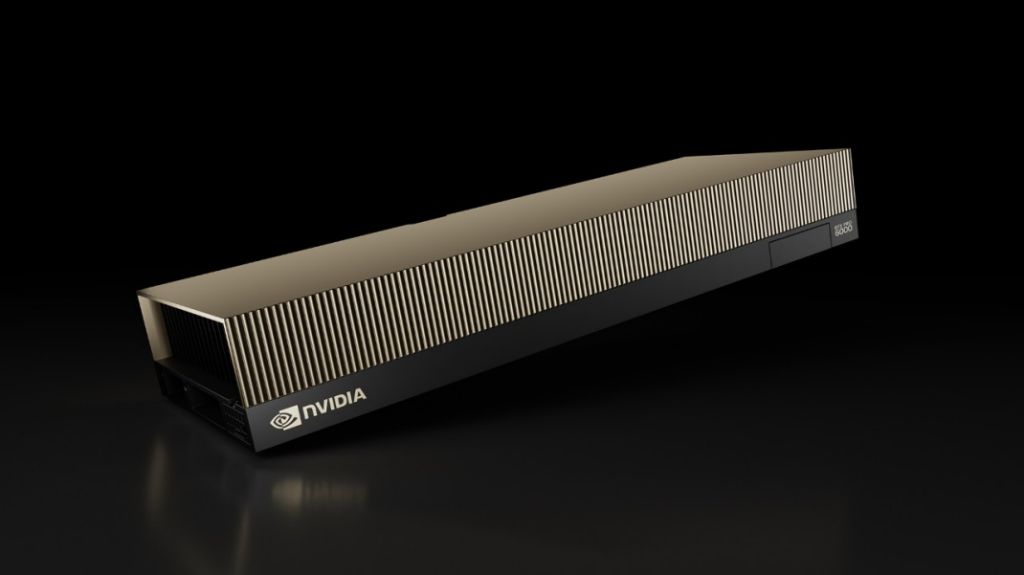
Ada Lovelace 기반 범용 데이터센터 GPU.
FP4·FP8·BF16 등 다양한 정밀도를 지원하는 Tensor Core로 학습·추론 성능을 극대화.
최대 1.8TB/s NVLink로 GPU 간 통신 병목을 제거합니다.
단일 GPU를 최대 7개 인스턴스로 분할하여 다중 워크로드를 안전하게 분리.
CUDA·cuDNN·TensorRT 생태계와 완전히 호환되어 마이그레이션이 용이합니다.
AI NETWORKING
AI 팩토리를 위한 InfiniBand·Spectrum-X·BlueField DPU 등 NVIDIA 네트워킹 솔루션입니다.
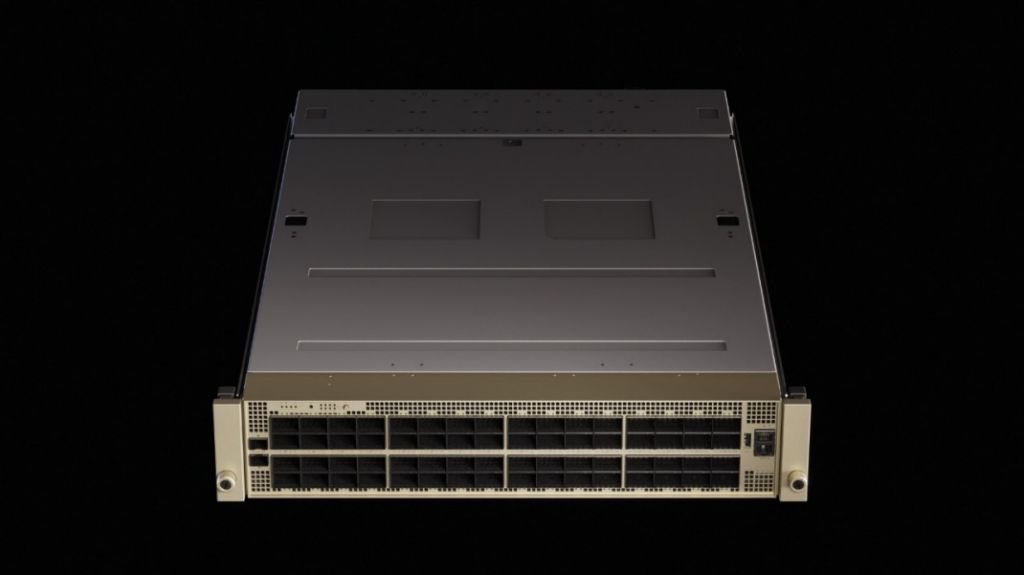
800Gb/s 차세대 무손실 AI 네트워크 스위치.
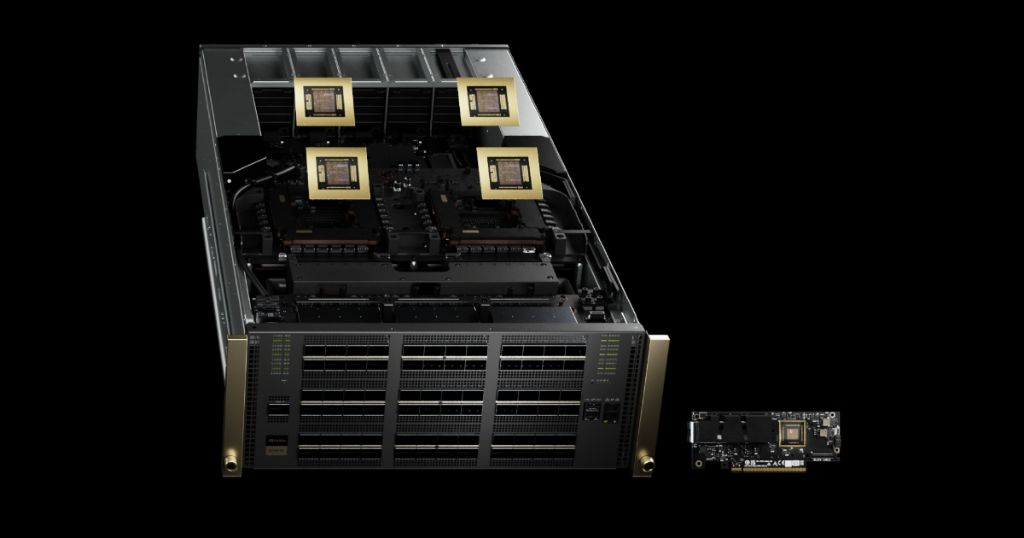
400Gb/s NDR 검증된 AI/HPC 표준 네트워크.
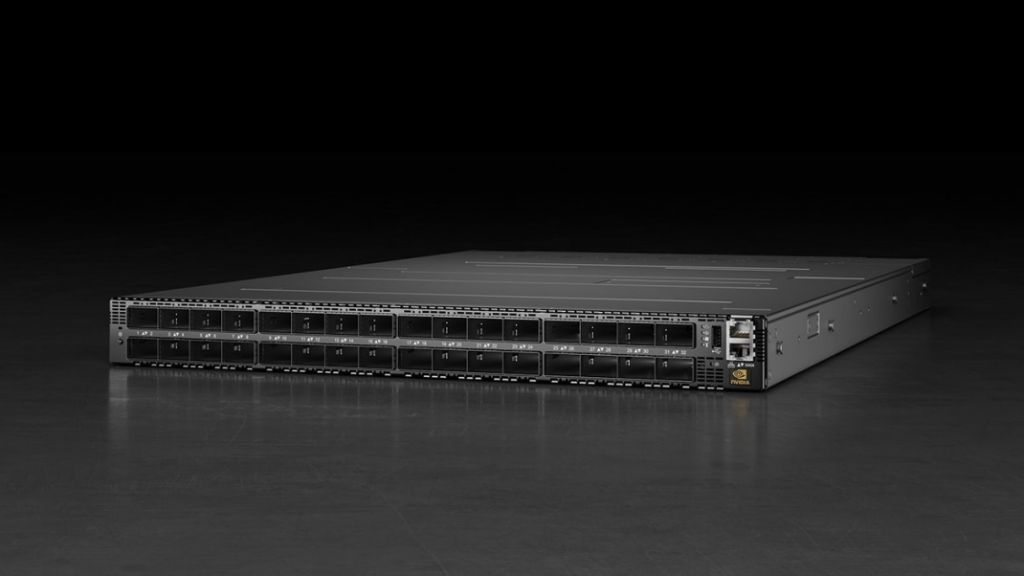
세계 최초 AI 전용 이더넷·1.6× 성능 향상.
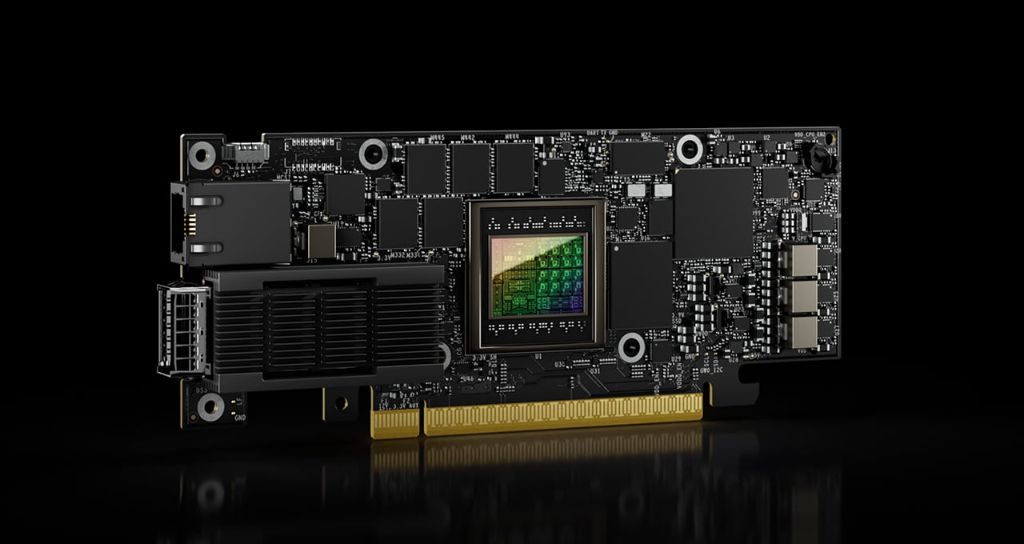
네트워크·스토리지·보안 오프로드 DPU.
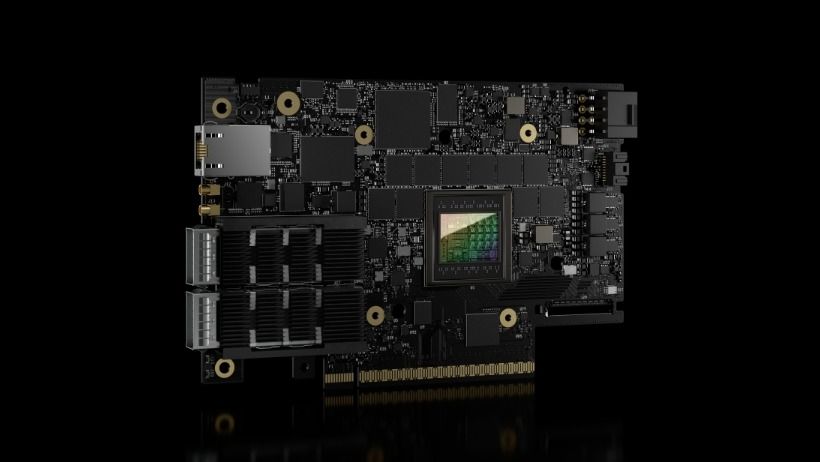
800Gb/s 초저지연 GPU-to-GPU 통신 NIC.
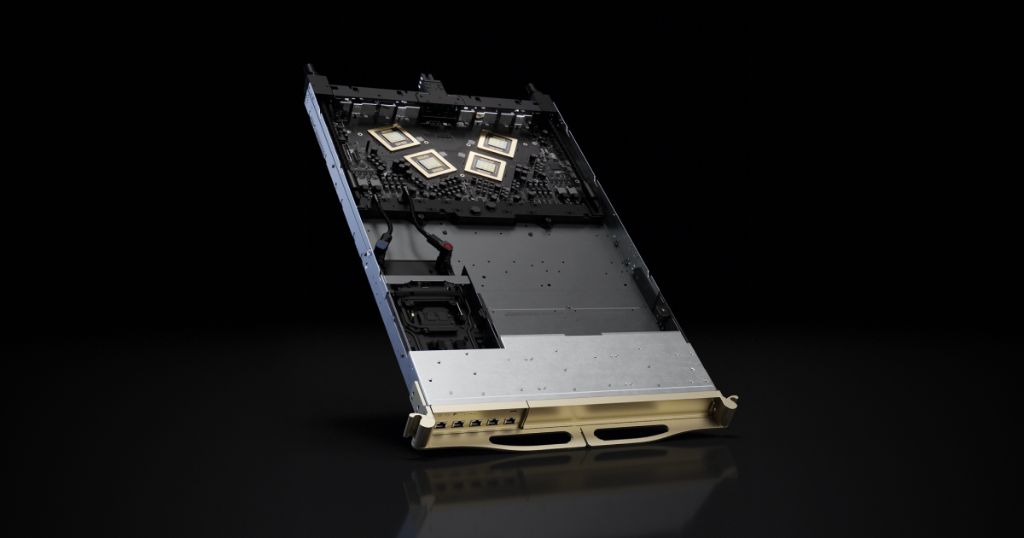
GPU 간 1.8TB/s 풀-메시 NVLink 스위치.
In-Network Computing(SHARP)으로 집합 통신을 가속, AI 학습 시간을 단축합니다.
실시간 트래픽 분석 기반의 적응형 라우팅으로 혼잡을 자동 회피합니다.
GPU 메모리 간 직접 RDMA를 지원하여 호스트 CPU·메모리 오버헤드를 제거.
GPU·DPU·스위치·케이블·소프트웨어까지 NVIDIA 단일 벤더 통합 설계 지원.
RTX PRO WORKSTATION
AI 개발·3D 렌더링·콘텐츠 제작을 위한 NVIDIA RTX PRO 워크스테이션 GPU 라인업입니다.
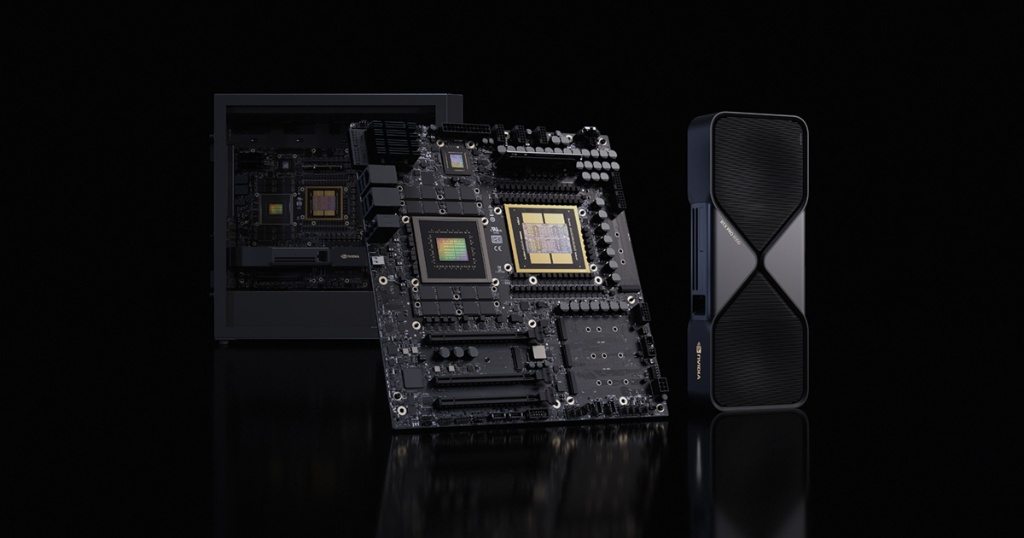
NVIDIA GB300 Grace Blackwell Ultra Superchip 기반 데스크사이드 AI 슈퍼컴퓨터 워크스테이션.
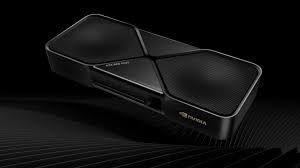
Blackwell 96GB GDDR7 최상위 워크스테이션 GPU.
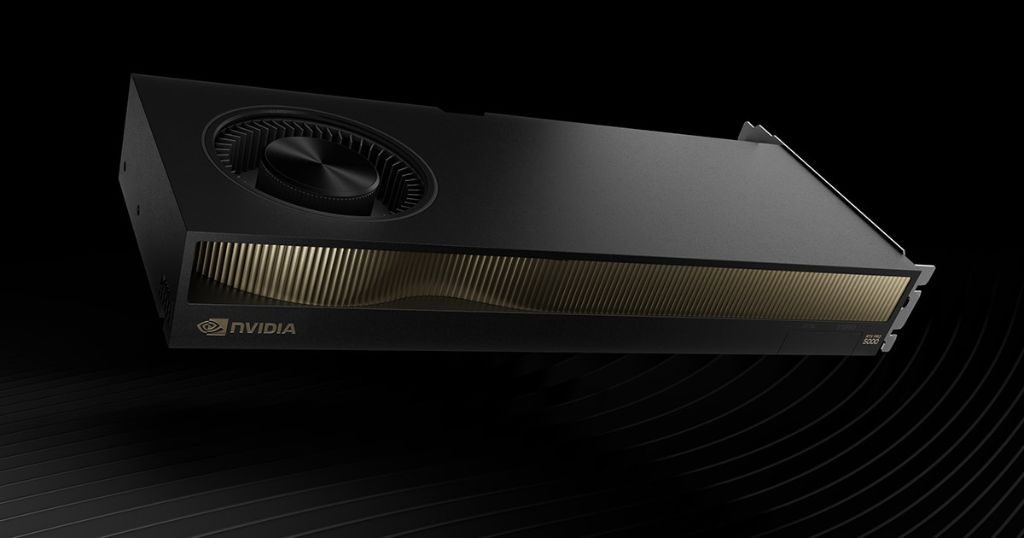
워크스테이션·랩탑용 차세대 AI·CAD GPU.
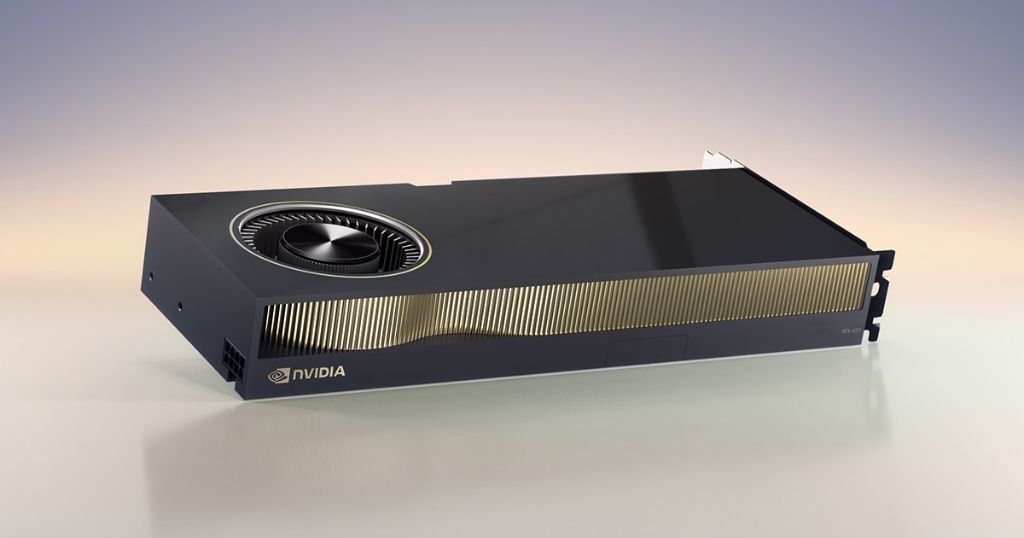
48GB GDDR6 ECC Ada Lovelace 프로 GPU.
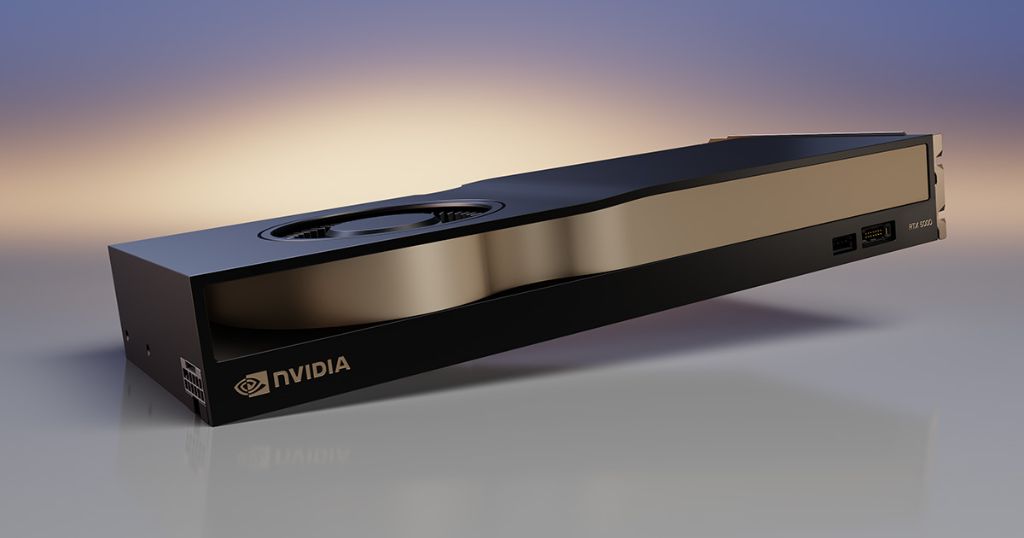
32GB AI·시뮬레이션·렌더링 워크스테이션 GPU.
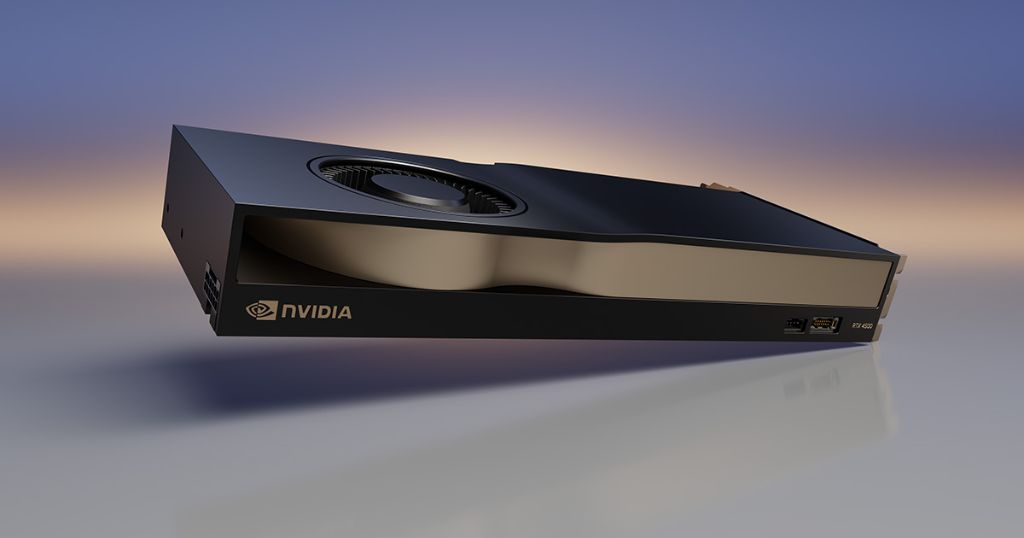
24GB BIM·시각화·중급 AI 합리적 선택.
대용량 GPU 메모리로 로컬 LLM·LoRA 파인튜닝·생성형 AI 프로토타이핑이 가능합니다.
Autodesk·Adobe·Dassault 등 주요 ISV의 인증 드라이버로 안정성 보장.
3세대 RT 코어와 4세대 Tensor 코어로 사실적 렌더링과 AI 가속 동시 지원.
NVIDIA Omniverse 기반 실시간 협업·디지털 트윈 워크플로우에 최적화.
AI SOFTWARE PLATFORM
엔터프라이즈 AI 개발·배포·운영을 위한 NVIDIA 풀스택 소프트웨어 플랫폼입니다.
클라우드 네이티브 AI 개발·배포 플랫폼.
사전 최적화 추론 마이크로서비스 분 단위 배포.
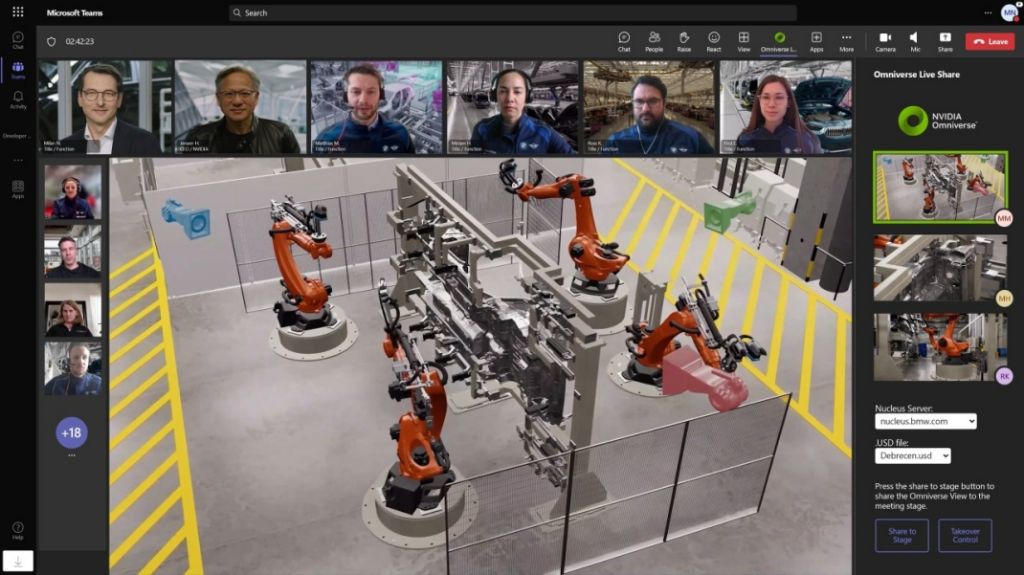
실시간 3D 시뮬레이션·디지털 트윈 플랫폼.
GPU 컴퓨팅 표준 플랫폼과 딥러닝 라이브러리.
추론 최적화 SDK·처리량 극대화.
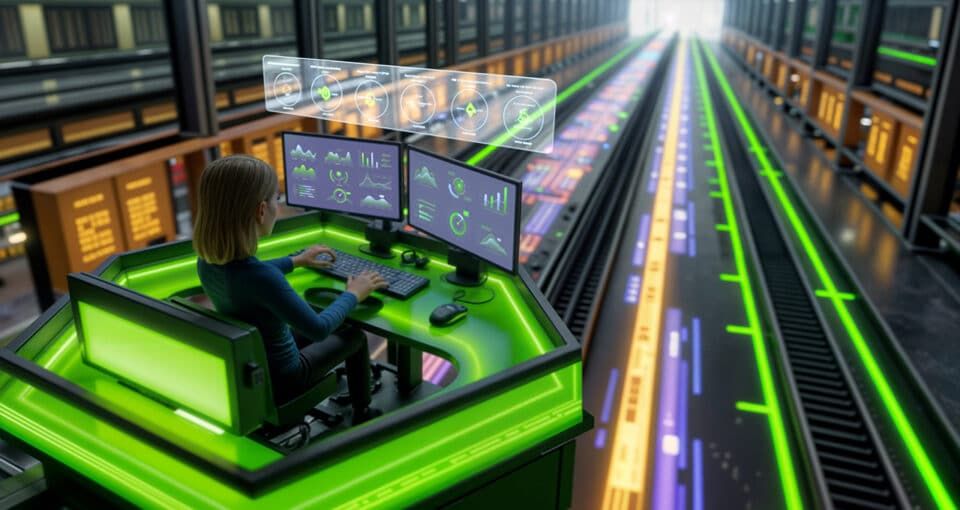
AI 팩토리 운영 관리·통합 모니터링 플랫폼.
AI Enterprise 라이선스로 NVIDIA 글로벌 기술지원과 SLA를 보장합니다.
NGC 카탈로그의 사전 검증·최적화된 컨테이너로 즉시 워크로드 실행.
Kubernetes·Run:ai·Slurm 등 주요 오케스트레이션 도구와 완전히 통합됩니다.
데이터센터·엣지·클라우드·워크스테이션까지 동일 코드로 배포 가능합니다.
RTX FOR OMNIVERSE
Omniverse·디지털 트윈·생성형 AI 시뮬레이션을 위한 NVIDIA RTX 가속 RTX 서버입니다.
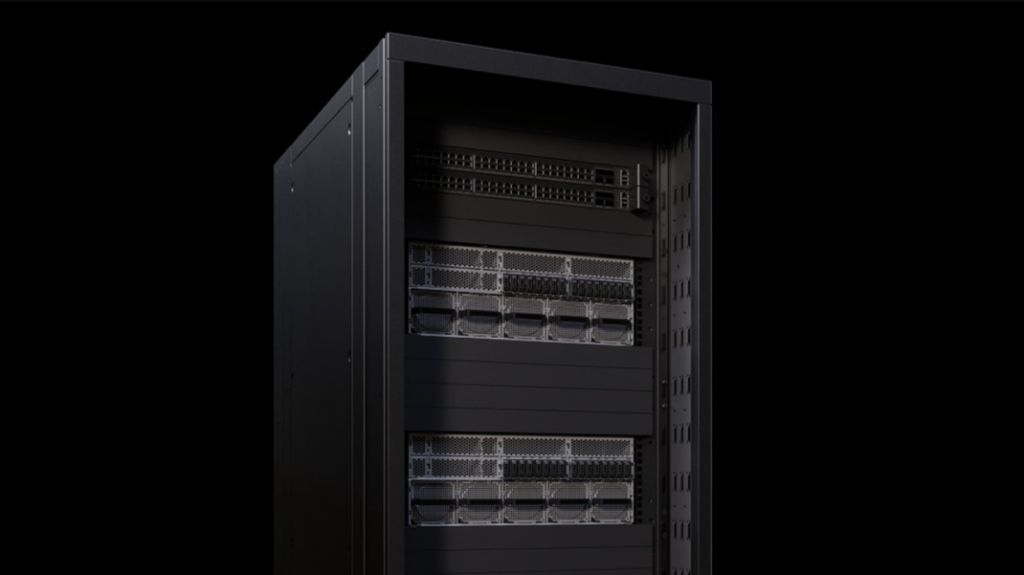
RTX Pro6000 Blackwell 8장 RTX 레퍼런스 Omniverse 서버.
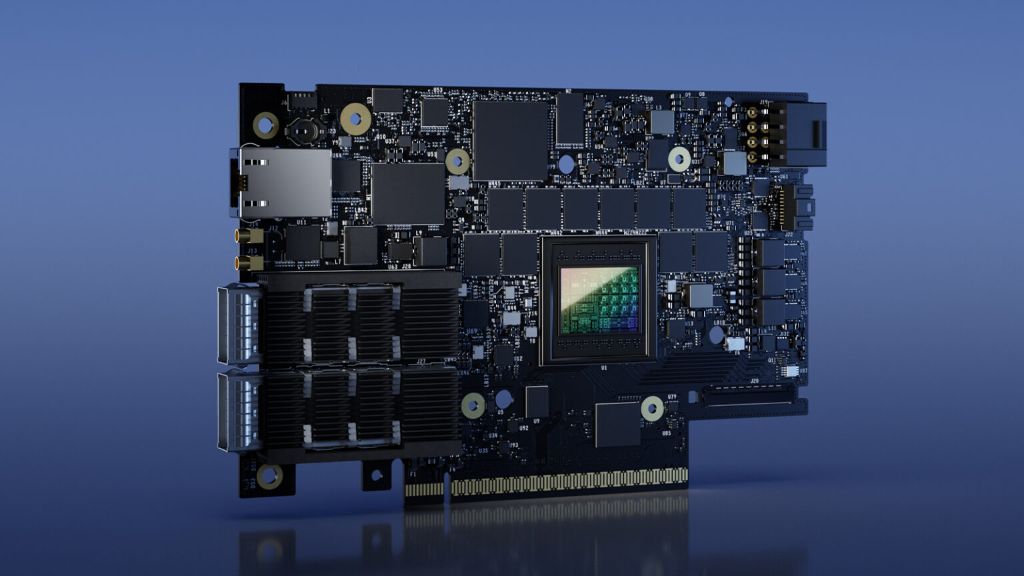
BlueField DPU 통합 멀티테넌트 RTX 노드.
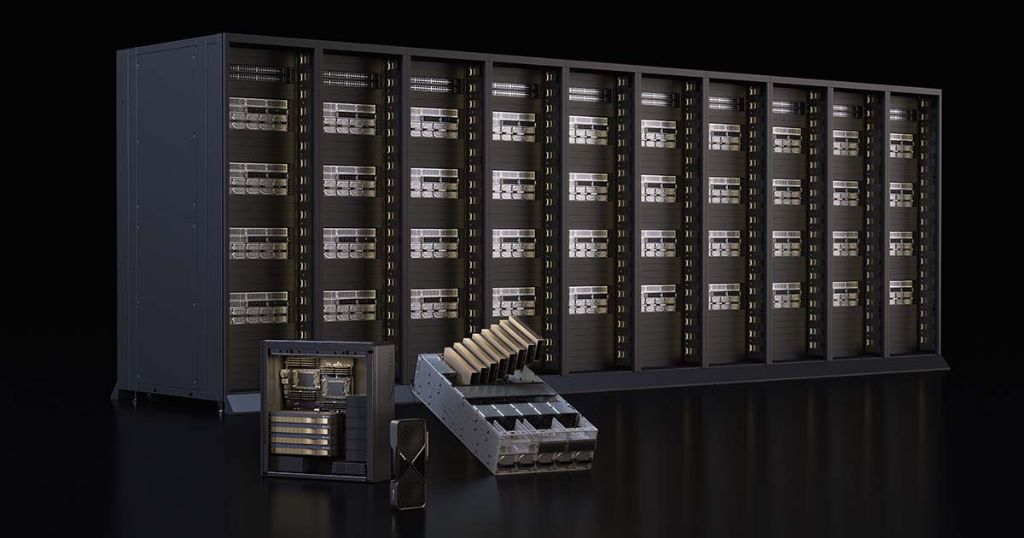
대규모 산업용 디지털 트윈 RTX 클러스터.
Supermicro·Dell·HPE·Lenovo 인증 RTX.
RTX 코어 기반 실시간 패스 트레이싱으로 사실적 디지털 트윈 시뮬레이션 가능.
USD 기반 멀티유저 실시간 협업으로 글로벌 팀이 동일 환경을 공유합니다.
제조·물류·로보틱스·자율주행 등 산업용 시뮬레이션 워크로드에 최적화.
단일 노드부터 SuperPOD까지 단계적 확장이 가능한 검증된 레퍼런스 설계.
EDGE AI · ROBOTICS
로보틱스·엣지 AI·자율 시스템을 위한 NVIDIA Jetson 임베디드 컴퓨팅 플랫폼입니다.
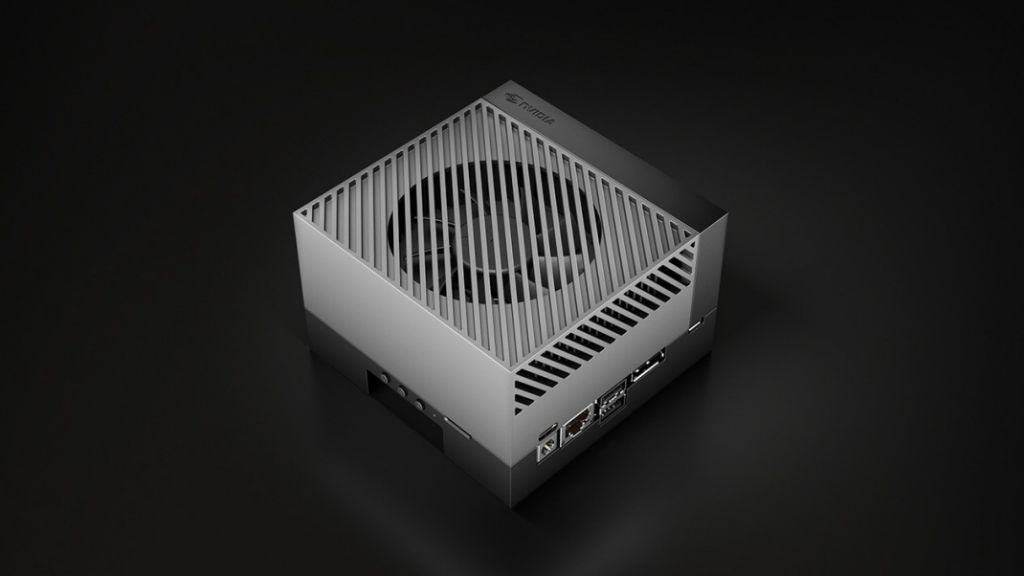
Blackwell 기반 휴머노이드·자율머신 엣지 AI.
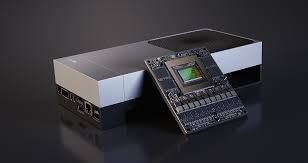
275 TOPS 산업용 로보틱스 플래그십 모듈.
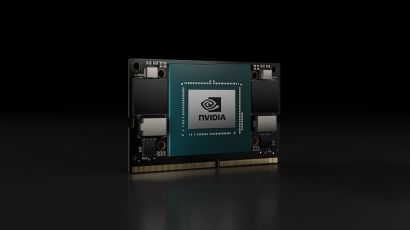
100 TOPS 소형 모듈·드론·AMR에 적합.
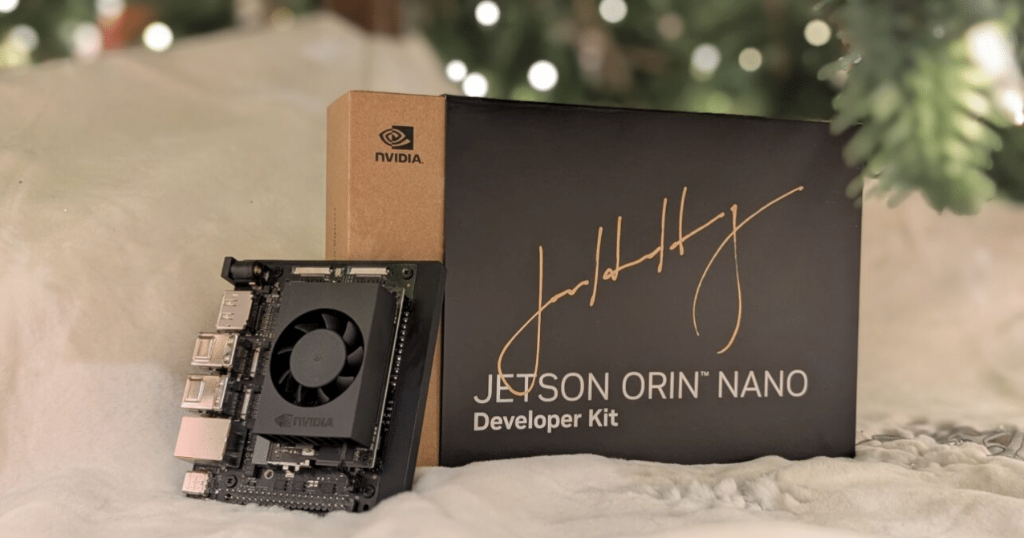
40 TOPS 입문형 교육·프로토타이핑 모듈.
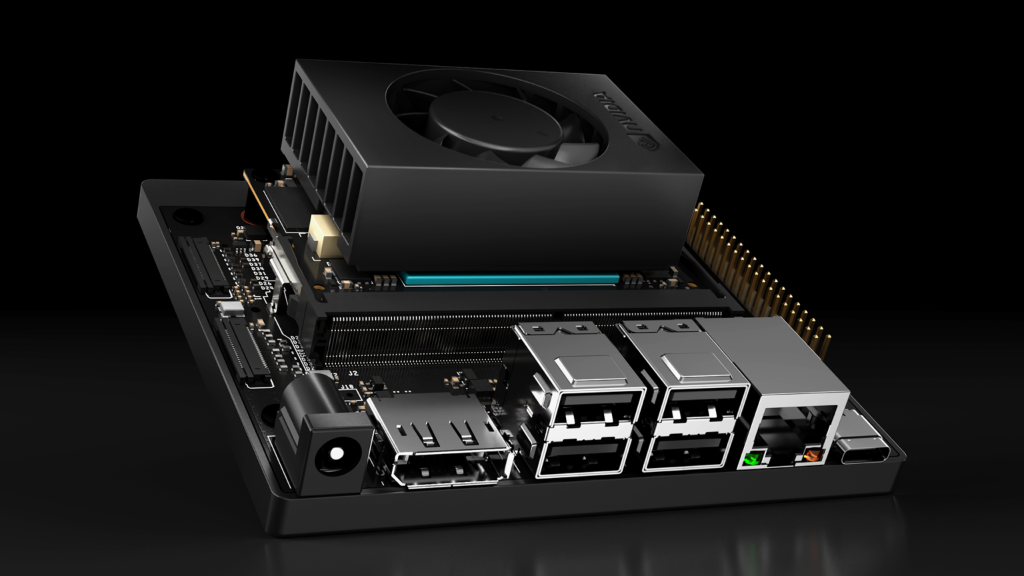
강화 성능 Nano·생성형 AI 엣지 가속.
CPU·GPU·DLA·비전 가속기를 통합한 SoC로 엣지에서 풀스택 AI 추론을 수행.
CUDA·TensorRT·DeepStream·Isaac 등 NVIDIA AI 스택을 그대로 엣지에 적용.
7~60W 범위의 전력 프로파일로 배터리 기반 모바일 로봇에도 탑재 가능합니다.
Isaac ROS·Sim과 연계하여 시뮬레이션-실기계 간 매끄러운 워크플로우를 지원.
전문 컨설턴트가 신속하게 답변드립니다.